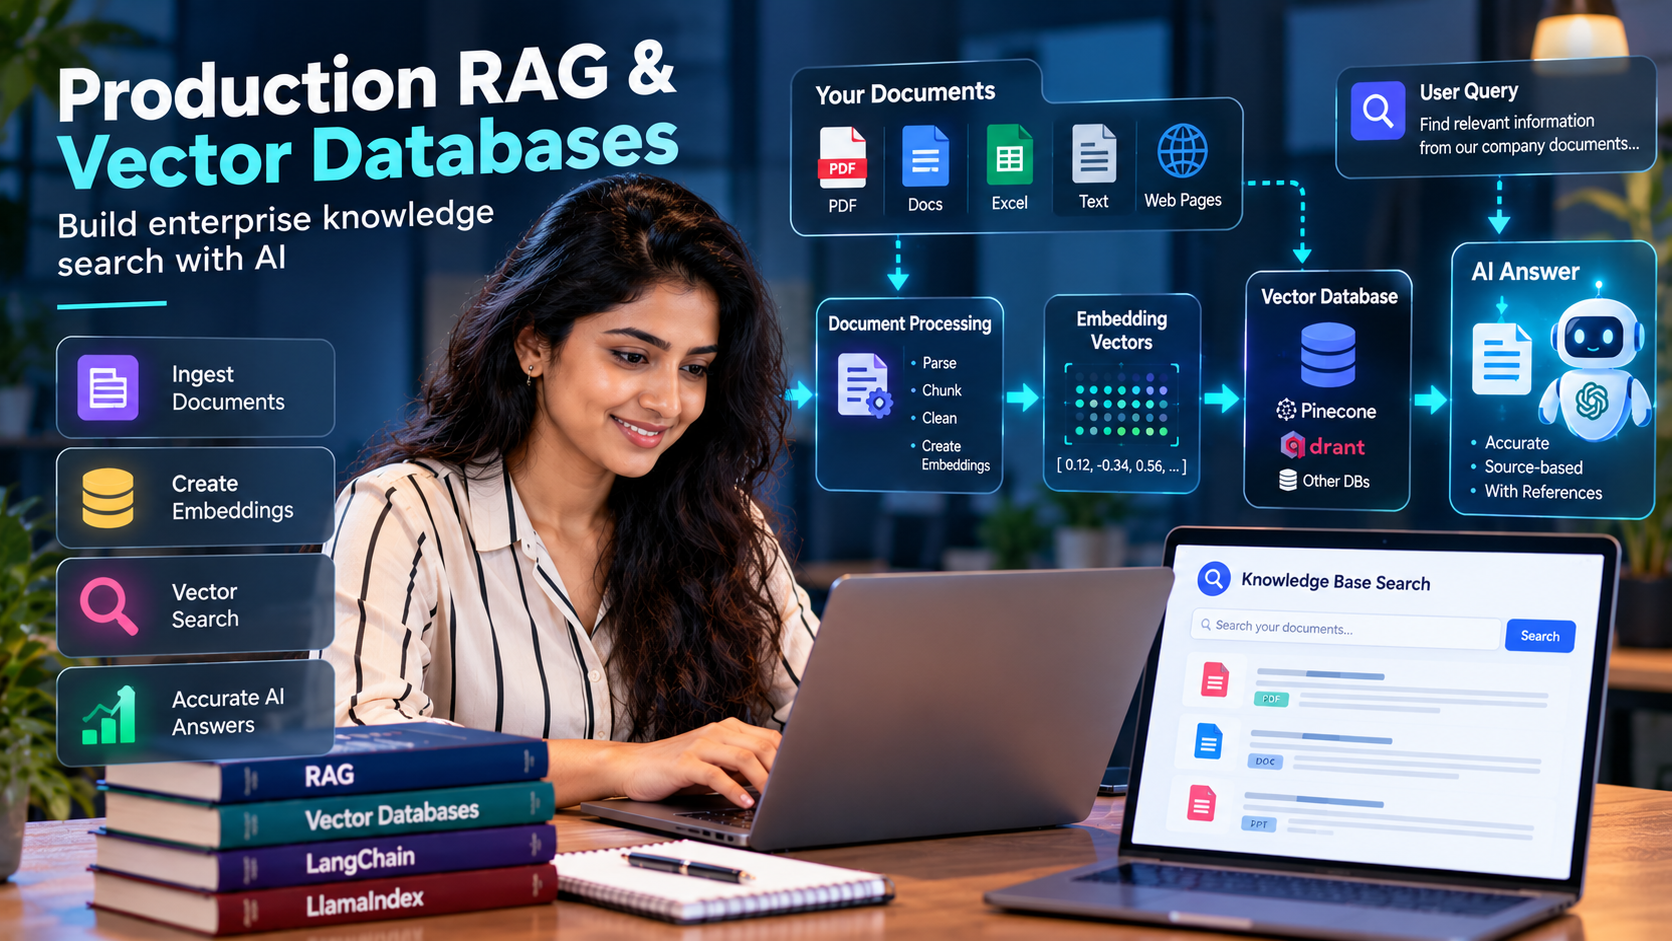
Build retrieval-augmented generation systems that search internal documents and return grounded answers with evidence. 1. Who can join
Suitable for: AI application developers, backend engineers and data specialists Mandatory prerequisites: Python, REST APIs and introductory embeddings or NLP concepts 2. Duration
44 live hours • Approximately 8 weeks at 6 hours per week; actual timetable to be confirmed. 3. Mode
Classroom - Thaiyur / Kelambakkam, OMR Chennai (subject to schedule)
Live Online (subject to schedule) 4. Syllabus — five modules
Module 1: RAG Architecture & Vector Search Fundamentals Learning outcome: Compare RAG architecture, embeddings and semantic search. Module 2: Document Ingestion Pipeline: Advanced Parsing, Semantic Chunking & Embedding Selection Learning outcome: Parse PDFs, create chunks and select embedding strategies. Module 3: Vector Databases in Action: Setup, Indexing & Querying in Pinecone & Qdrant Learning outcome: Index and query documents using a vector database. Module 4: Hybrid Search, Re-Ranking Strategies & Query Expansion Learning outcome: Improve relevance with hybrid search, re-ranking and query rewriting. Module 5: RAG Evaluation Frameworks (Ragas, TruLens) & Fine-Tuning Retrieval Learning outcome: Evaluate retrieval and responses using measurable test cases. 5. Practical project
Source capstone title: Build an Enterprise Knowledge Base Search Engine for PDF Contracts Student deliverable: A searchable collection of sample PDF contracts with a document ingestion pipeline, semantic and keyword retrieval, citations and answer-quality evaluation. 6. What is included
Live trainer-led sessions Practical assignments Sample code or templates, as applicable Project feedback Learning assessment Perizona course-completion certificate subject to assessment 7. Upcoming batch
Start date: To be announced. Students can register interest; dates are shared only after confirmation.